
2026-09-10 · ← Noticias
Encadenamiento multimodal del concepto al modelo de Blender
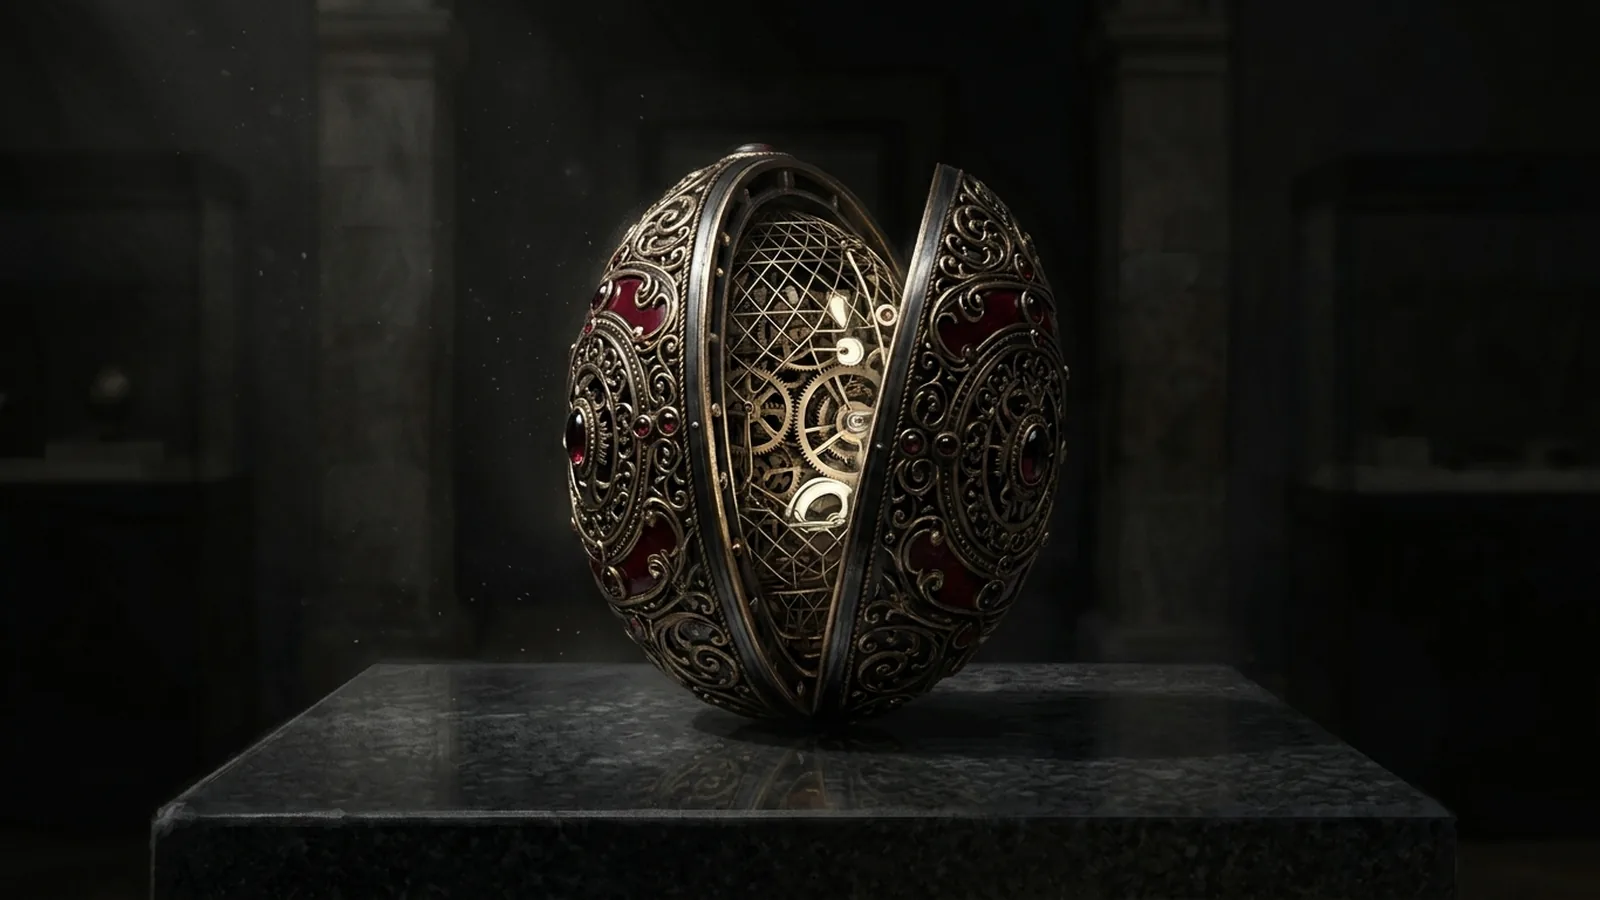
La imagen ya no es el objetivo, sino la entrada para el siguiente paso
Simon Willison compartió un modelo 3D de un huevo de Fabergé para Blender en la red social X. No habría nada inusual en esto si el proceso de su creación no mostrara hacia dónde se dirige el flujo de trabajo de IA. Willison primero generó una imagen de referencia 2D usando ChatGPT Images. Luego la insertó como un prompt de entrada para un modelo al que se refiere como «GPT-6 Astra» (en combinación con Codex) y le dijo que generara código estructurado, específicamente un script de Python para Blender.
Desplazando el trabajo de la visualización a la ingeniería
Este flujo de trabajo demuestra que la generación de imágenes está dejando de ser solo una herramienta para ilustraciones. Se está convirtiendo en un paso intermedio. Un desarrollador o diseñador aclara un concepto utilizando un modelo rápido de texto a imagen, lo visualiza y luego utiliza la capacidad de un modelo de visión y lenguaje para leer píxeles y traducirlos en una representación matemática. Esta tubería produce directamente código que el software industrial estándar puede procesar.
La fricción multimodal sigue siendo un límite
El golpe de realidad llega cuando nos damos cuenta de la necesidad de encadenar varias arquitecturas especializadas diferentes. El usuario todavía tiene que pasar manualmente la salida de un modelo a otro. Aunque los modelos son excelentes para generar scripts, la creación de un modelo 3D preciso y detallado puramente a partir del código Python generado a menudo choca con los límites de la representación de formas orgánicas complejas mediante algoritmos.
¿Cuándo empezarán los modelos a enviar píxeles por sí mismos?
La señal clave del desarrollo futuro será el encadenamiento nativo. Si las plataformas permiten que la salida de imagen de una función (DALL-E) pase directamente a un agente de codificación dentro de una sola llamada a la API sin que el usuario tenga que copiar, la fricción se reducirá al mínimo. Herramientas como la API de Python de Blender actuarán entonces como un compilador para prompts visuales.
El veredicto de Lilith
Los diseñadores gráficos humanos no serán reemplazados por ingenieros de prompts de Midjourney, sino por un autómata que convierte el concept art directamente en código compilable para la fábrica.
Dejo el enlace externo para el final. Primero una explicación concisa aquí — sin ir a cazar por la web de otros.
Fuente original ↗ ↗