
2026-09-10 · ← Aktualności
Multimodalne łańcuchowanie od konceptu do modelu Blendera
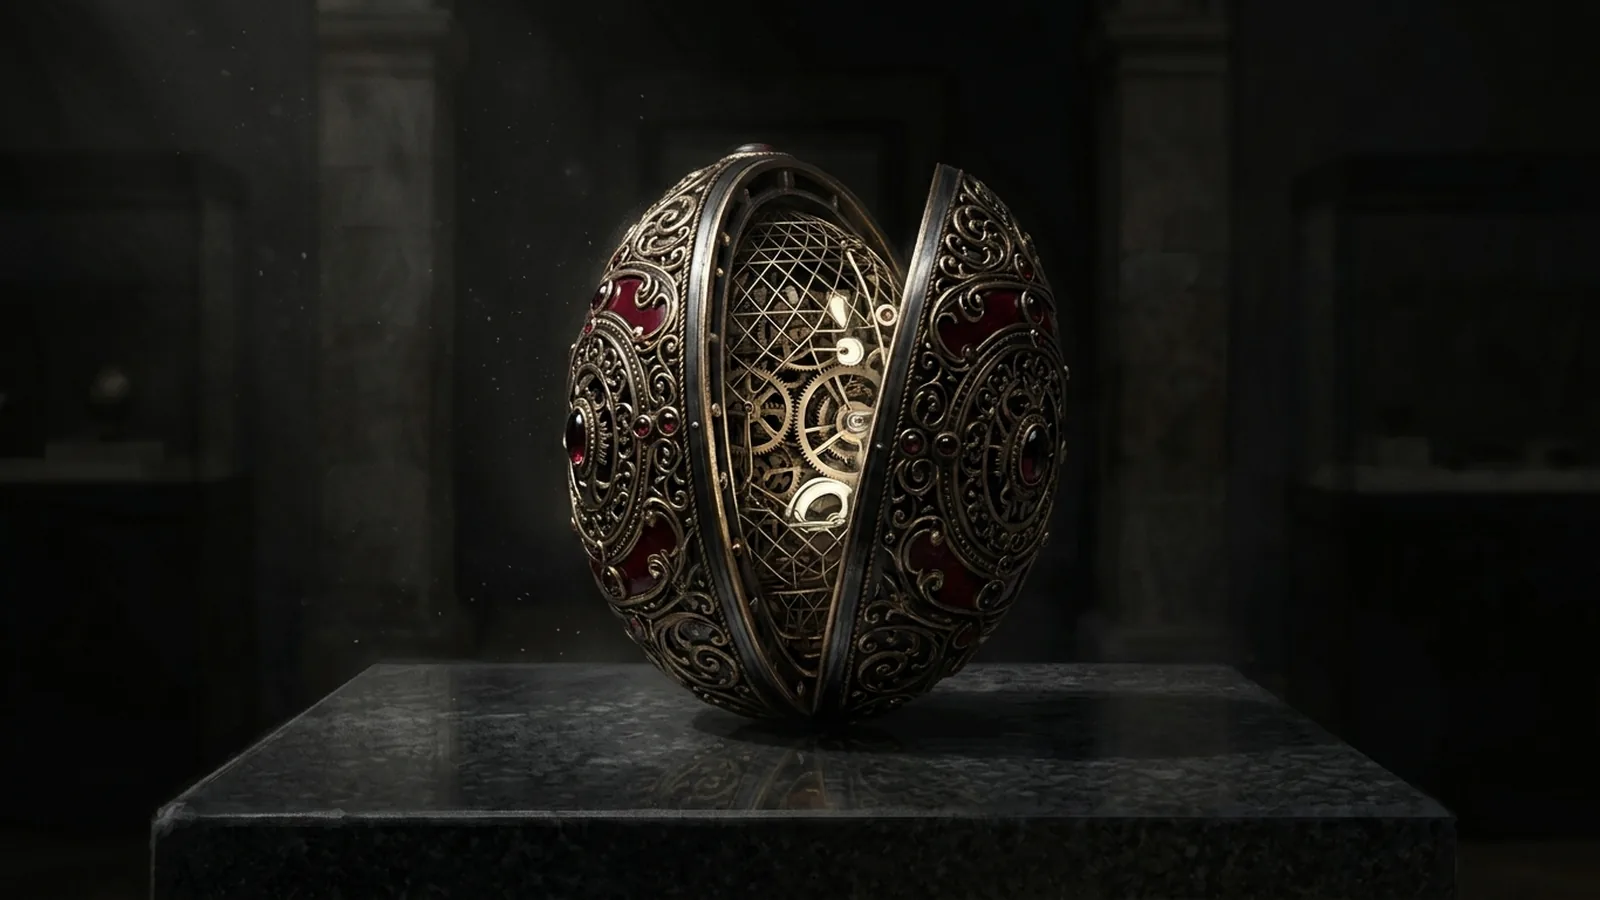
Obraz nie jest już celem, ale zadaniem dla kolejnego kroku
Simon Willison udostępnił w sieci społecznościowej X model 3D jaja Fabergé dla Blendera. Nie byłoby w tym nic dziwnego, gdyby proces jego powstawania nie pokazywał, w jakim kierunku zmierza przepływ pracy AI. Willison najpierw wygenerował referencyjny obraz 2D za pomocą ChatGPT Images. Następnie użył go jako promptu wejściowego dla modelu, który nazywa „GPT-6 Astra” (w połączeniu z Codexem), i kazał mu wygenerować z obrazu ustrukturyzowany kod, czyli skrypt w Pythonie dla Blendera.
Przesunięcie pracy z wizualizacji do inżynierii
Ten przepływ pracy pokazuje, że generowanie obrazów przestaje być tylko narzędziem do ilustracji. Staje się krokiem pośrednim. Deweloper lub projektant doprecyzowuje koncepcję za pomocą szybkiego modelu text-to-image, wizualizuje ją, a następnie wykorzystuje zdolność modelu vision-language do odczytania pikseli i przetłumaczenia ich na reprezentację matematyczną. Takie zadanie od razu generuje kod, z którym radzi sobie standardowe oprogramowanie przemysłowe.
Multimodalne tarcie pozostaje barierą
Rzeczywistość weryfikuje nas w momencie, gdy uświadamiamy sobie konieczność łączenia ze sobą kilku różnych wyspecjalizowanych architektur. Użytkownik wciąż musi ręcznie przekazywać dane wyjściowe z jednego modelu do drugiego. Chociaż modele świetnie radzą sobie z generowaniem skryptów, stworzenie precyzyjnego i szczegółowego modelu 3D wyłącznie z wygenerowanego kodu w Pythonie często natrafia na ograniczenia w reprezentacji złożonych kształtów organicznych za pomocą algorytmów.
Kiedy modele zaczną same przesyłać piksele?
Kluczowym sygnałem przyszłego rozwoju będzie natywne łańcuchowanie. Jeśli platformy pozwolą na bezpośrednie przekazywanie obrazu z jednej funkcji (DALL-E) do agenta kodującego w ramach jednego wywołania API bez kopiowania przez użytkownika, tarcia zostaną zminimalizowane. Narzędzia takie jak Blender Python API będą wtedy działać jak kompilator dla wizualnych promptów.
Werdykt Lilith
Ludzkich grafików nie zastąpią inżynierowie promptów Midjourney, ale automat, który bezpośrednio zamieni concept art w kod kompilowalny dla fabryki.
Link zewnętrzny zostawiam na koniec. Najpierw krótkie wyjaśnienie tutaj, bez polowania po cudzej stronie.
Oryginalne źródło ↗ ↗